Descubre las 15 tendencias de datos e inteligencia artificial que marcarán 2027-2028: agentes de IA, tiempo real, ontologías, soberanía, AI FinOps, gobierno y más.
Durante años, la estrategia de datos de muchas empresas se ha centrado en reunir información dispersa, trasladarla al cloud, mejorar su calidad y facilitar su explotación mediante herramientas de Business Intelligence y analítica.
Hoy, esa estrategia ya no es suficiente.
El avance de la inteligencia artificial está transformando tanto la manera de utilizar los datos como los requisitos que estos deben cumplir para generar valor. Por eso, en Bismart hemos analizado las tendencias en datos e IA que marcarán la evolución del mercado durante los próximos dos años.
Entre 2027 y 2028, el gran reto será conseguir que los datos puedan ser utilizados de forma fiable no solo por personas y dashboards, sino también por modelos de inteligencia artificial, copilots, agentes, aplicaciones y procesos capaces de recomendar, decidir e incluso actuar de manera autónoma.
Este cambio reordena las prioridades de la estrategia de datos empresarial. La semántica, el contexto, los permisos, la observabilidad, la soberanía, el acceso en tiempo real y el coste de inferencia dejan de ser cuestiones periféricas para convertirse en componentes esenciales de cualquier infraestructura preparada para operar con IA a escala.
Esta es una de las principales conclusiones de nuestro informe La Industria de los Datos y la IA en 2027-2028: Tendencias, Retos y Oportunidades, en el que analizamos las fuerzas tecnológicas, empresariales y regulatorias que pueden transformar el mercado durante los próximos años.
De almacenar datos a construir sistemas capaces de utilizarlos
La industria de los datos está entrando en una nueva etapa. Durante la última década, el objetivo dominante fue reunir más información, trasladarla al cloud, acelerar su procesamiento y ampliar el acceso a la analítica.
En 2027–2028, el reto será distinto: conseguir que los datos puedan ser utilizados de forma fiable por modelos de inteligencia artificial, agentes, aplicaciones y procesos que no solo analizan lo ocurrido, sino que también recomiendan, deciden y actúan.
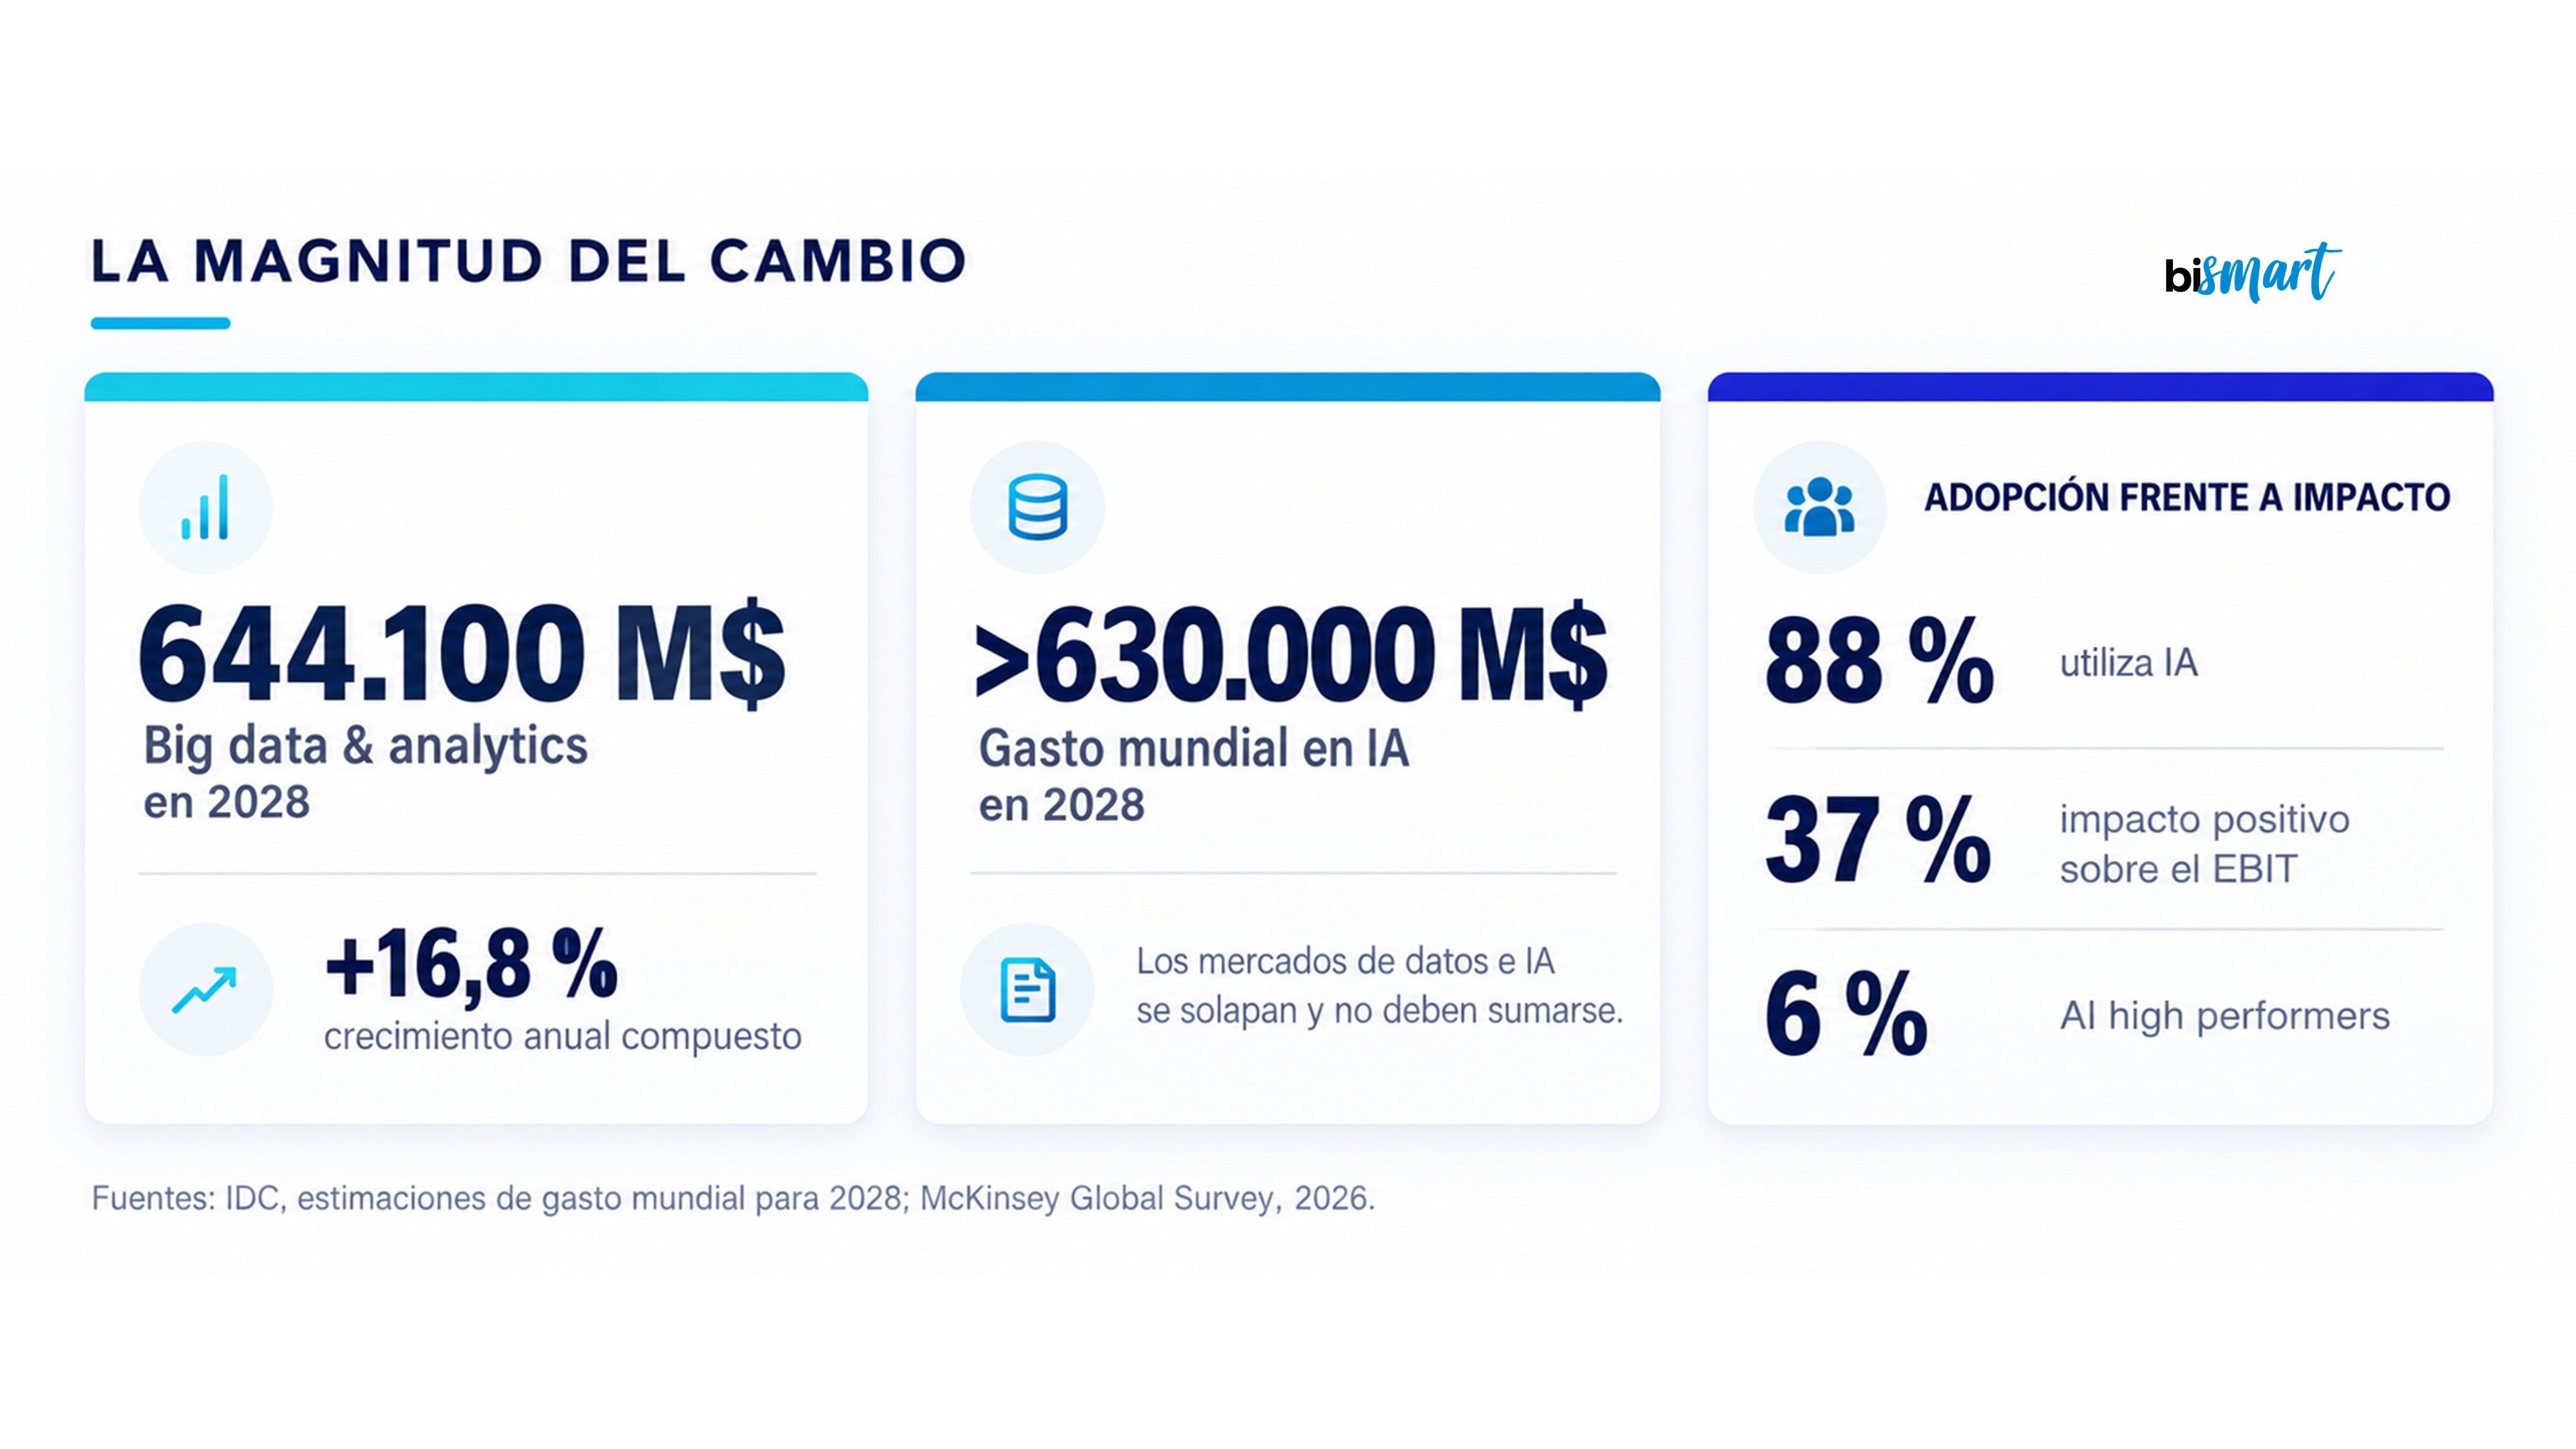
La magnitud económica del cambio es considerable. IDC estima que el gasto mundial en tecnologías de big data and analytics podría pasar de aproximadamente 354.000 millones de dólares en 2024 a cerca de 644.100 millones en 2028, con un crecimiento compuesto próximo al 16,8 %.
El gasto mundial en inteligencia artificial podría superar, por su parte, los 630.000 millones de dólares en 2028.
La adopción, sin embargo, no garantiza impacto.
En la encuesta global de McKinsey de 2026, el 88% de las organizaciones declaraba utilizar inteligencia artificial, pero solo el 37% señalaba un impacto positivo sobre el EBIT y apenas el 6% encajaba en la categoría de AI high performers.
Dato clave: El cuello de botella de 2027–2028 no será disponer de IA. Será disponer del sistema de datos, gobierno y operación capaz de convertirla en valor económico repetible y seguro.
Las mejores oportunidades no estarán necesariamente en crear otro dashboard ni otro modelo fundacional.
Se concentrarán en la capa que hace que la IA empresarial funcione con fiabilidad: productos de datos, observabilidad, capas semánticas, ingeniería de contexto, seguridad de agentes, privacidad computacional, streaming, datos sintéticos, gobernanza automatizada y optimización de infraestructura.
A partir de esta transformación, identificamos 15 tendencias de datos e inteligencia artificial que pueden definir el escenario empresarial de 2027-2028.
1. Gestión agéntica del ciclo de vida del dato
La automatización de data engineering evolucionará hacia sistemas capaces de intervenir de forma autónoma en distintas fases del ciclo de vida del dato.
Los agentes de IA no se limitarán a generar código: podrán descubrir fuentes, proponer pipelines, crear transformaciones, comprobar reglas de calidad, actualizar metadatos, optimizar cargas y asistir en la resolución de incidencias.
Esta tendencia supone la evolución natural de DataOps. Las plataformas ya automatizan despliegues, pruebas y monitorización; la diferencia es que la nueva generación podrá interpretar el contexto de una incidencia, formular hipótesis y ejecutar una corrección dentro de límites predefinidos.
Implicación empresarial. El objetivo no será sustituir la función de data engineering, sino desplazarla desde la ejecución repetitiva hacia el diseño, la supervisión y la mejora de sistemas de datos cada vez más autónomos.
|
Capacidades esperadas |
Controles necesarios |
|
Descubrimiento de fuentes y documentación automática |
Verificación de procedencia y clasificación |
|
Generación y modificación de pipelines |
Sandbox, testing, versionado y rollback |
|
Detección y diagnóstico de incidencias |
Evidencias, explicación y umbrales de confianza |
|
Optimización de rendimiento y costes |
Límites de consumo y aprobación de cambios críticos |
2. Capas semánticas universales y ontologías empresariales
La capa semántica dejará de estar asociada exclusivamente al business intelligence. En 2027–2028 se convertirá en una infraestructura común para analítica, aplicaciones, copilots y agentes.
La consolidación de ontologías, grafos empresariales y métricas gobernadas permitirá reutilizar el mismo contexto en BI, búsqueda, automatización y aplicaciones de IA.
Iniciativas como Microsoft Fabric IQ reflejan esta evolución hacia un modelo operacional compartido de entidades, relaciones y reglas.
Implicación empresarial. La preparación para IA no consiste únicamente en mover datos al cloud. Requiere convertir conocimiento de negocio —hoy distribuido entre personas, documentos, código y dashboards— en una capa semántica gobernada y reutilizable.
|
De la capa semántica tradicional |
Hacia la capa semántica universal |
|
Métricas para informes |
Métricas para informes, aplicaciones y agentes |
|
Modelos centrados en BI |
Entidades, relaciones, procesos y reglas |
|
Consumo principalmente humano |
Consumo humano y automático |
|
Actualización por equipos analíticos |
Gobierno compartido entre datos y negocio |
3. Context Engineering, GraphRAG y memoria para agentes
La disciplina emergente de context engineering se centrará en seleccionar y construir dinámicamente la información, las instrucciones, las herramientas y la memoria que necesita cada interacción.
El RAG tradicional, basado principalmente en búsqueda vectorial sobre documentos, seguirá siendo relevante, pero resultará insuficiente para muchos procesos empresariales.
Las arquitecturas evolucionarán hacia recuperación híbrida: búsqueda léxica para coincidencias exactas, búsqueda vectorial para similitud semántica, grafos para relaciones entre entidades y mecanismos temporales para comprender qué información era válida en un momento determinado.
GraphRAG permitirá responder preguntas que requieren recorrer relaciones y combinar evidencias distribuidas.
La memoria añade otra capa. Los agentes podrán conservar información episódica sobre interacciones anteriores, conocimiento semántico sobre el negocio y procedimientos sobre cómo ejecutar una tarea.
Implicación empresarial. La ventaja no procederá de almacenar más documentos en un índice vectorial, sino de construir un sistema de contexto capaz de recuperar la evidencia correcta, justificarla y utilizarla con permisos adecuados.
4. Agentic Data Streaming y Operational Intelligence
El streaming pasará de alimentar dashboards en tiempo real a activar sistemas que interpretan eventos y actúan sobre ellos.
Un agente podrá detectar una anomalía, consultar antecedentes, evaluar reglas, proponer una respuesta, ejecutar una acción dentro de sus límites y escalar la decisión cuando sea necesaria la intervención humana.
Para que este modelo funcione, una plataforma de datos necesita más que velocidad. Debe gestionar evolución de esquemas, consistencia entre eventos y sistemas de registro, deduplicación, trazabilidad y observabilidad de datos end-to-end.
Implicación empresarial. La métrica relevante dejará de ser únicamente cuántos eventos se procesan por segundo. Será cuánto tiempo tarda la organización en detectar, decidir y actuar, y qué impacto genera esa respuesta.
5. Convergencia entre datos operacionales, analíticos y de IA
Durante décadas, los sistemas transaccionales y analíticos se diseñaron para funciones distintas. Los primeros priorizaban la consistencia y la ejecución de operaciones; los segundos, la agregación y el análisis histórico.
En 2027–2028, esa distancia continuará reduciéndose mediante CDC administrado, mirroring, arquitecturas zero-ETL, acceso zero-copy, bases de datos operacionales conectadas a lakehouses y sistemas híbridos transaccionales-analíticos.
La inteligencia artificial acelera esta convergencia porque los agentes necesitan combinar el estado actual de un proceso con el historial y el contexto de negocio.
Implicación empresarial. Las organizaciones deberán diseñar arquitecturas alrededor de los flujos de decisión y no de categorías tecnológicas heredadas. El criterio será dónde debe vivir cada carga para cumplir sus SLO con el menor movimiento y duplicación posible.
|
Mecanismo |
Qué reduce |
Consideración |
|
CDC y mirroring |
Latencia de sincronización |
Consistencia y evolución de esquemas |
|
Zero-ETL |
Pipelines personalizados |
Dependencia del ecosistema |
|
Zero-copy |
Copias físicas |
Compatibilidad real entre motores |
|
HTAP |
Separación estricta OLTP/OLAP |
Aislamiento y rendimiento |
|
Gobierno unificado |
Políticas duplicadas |
Cobertura de sistemas operacionales |
6. Ingeniería de datos multimodales y no estructurados
La mayor parte del conocimiento empresarial no reside en tablas. Está distribuido en contratos, correos, presentaciones, imágenes, vídeo, audio, planos, datos geoespaciales, telemetría y conversaciones.
La expansión de modelos multimodales convertirá estos contenidos en una fuente activa para analítica, automatización y agentes.
La ingeniería de datos deberá incorporar extracción documental, transcripción, visión, clasificación, segmentación, generación de embeddings y vinculación con entidades empresariales. No bastará con guardar un documento: será necesario conocer su versión, procedencia, idioma, nivel de confidencialidad, derechos de uso y relación con otros activos.
Implicación empresarial. Activar datos no estructurados puede liberar una parte sustancial del conocimiento corporativo, pero exige tratarlos con la misma disciplina de gobierno aplicada a los datos tabulares.
7. Open Table Formats y catálogos interoperables
Formatos como Apache Iceberg, Delta Lake y Apache Hudi han consolidado una capa de tablas sobre almacenamiento de objetos. El siguiente paso será aumentar la interoperabilidad entre catálogos, motores y plataformas para que una organización pueda utilizar distintos servicios sobre los mismos activos sin duplicarlos continuamente.
La separación entre almacenamiento, catálogo de datos y procesamiento cambia el equilibrio del ecosistema. El dato puede permanecer en un formato abierto mientras diferentes motores se encargan de ingeniería, analítica o inteligencia artificial.
Los catálogos evolucionarán desde inventarios descriptivos hacia planos de control activos. Además de facilitar búsqueda y linaje, podrán aplicar políticas, validar contratos, activar workflows y proporcionar contexto a aplicaciones y agentes.
Estándares de metadatos como DCAT 3 pueden facilitar la búsqueda federada y el intercambio entre catálogos, especialmente en administraciones públicas y espacios de datos.
Implicación empresarial. La estrategia no debe basarse únicamente en que un proveedor declare soportar un formato abierto. Debe probarse la capacidad real de lectura, escritura, gobierno, exportación y recuperación fuera de la plataforma principal.
|
Nivel de apertura |
Pregunta de validación |
|
Formato |
¿Los datos se almacenan en una especificación abierta? |
|
Catálogo |
¿Otros motores pueden descubrir y gobernar las tablas? |
|
Procesamiento |
¿Pueden utilizarse distintos motores sin replicación? |
|
Seguridad |
¿Se mantienen permisos y auditoría entre plataformas? |
|
Salida |
¿Existe un procedimiento probado de exportación y recuperación? |
8. Small Language Models y Edge AI
Los modelos pequeños y especializados ganarán espacio frente al supuesto de que cada tarea necesita el modelo más grande disponible.
Los Small Language Models pueden ofrecer una relación más eficiente entre capacidad, coste y latencia, especialmente cuando el problema está bien delimitado o requiere ejecución frecuente.
Combinados con edge computing, estos modelos permiten realizar inferencia cerca de donde se generan los datos: fábricas, vehículos, tiendas, dispositivos médicos, redes de telecomunicaciones o infraestructuras energéticas. Esto reduce latencia, transferencia de información y dependencia de conectividad permanente.
Implicación empresarial. La selección de modelos debe convertirse en una decisión de arquitectura basada en riesgo, complejidad, coste, latencia y ubicación del dato, no en una competición por utilizar el modelo más potente.
9. Sovereign AI y Regional Data Planes
La soberanía se trasladará desde los departamentos jurídicos hacia el diseño de plataformas. Las organizaciones necesitarán conocer no solo dónde se almacena un dato, sino también dónde se procesa, qué modelo lo utiliza, dónde se guardan los logs, quién controla las claves y qué metadatos cruzan fronteras.
Los regional data planes permitirán separar cargas y activos según jurisdicción. Las políticas podrán decidir qué información se mantiene en una región, qué datos pueden agregarse, qué modelos se ejecutan localmente y en qué condiciones es posible una transferencia.
El concepto de sovereign AI amplía esta lógica al cómputo, los modelos, la operación y el conocimiento. Puede incluir infraestructura local, modelos regionales, gestión propia de claves, confidential computing y separación entre contenido y metadatos.
Implicación empresarial. La residencia del dato es solo una parte del problema. La organización debe poder demostrar la trayectoria completa de almacenamiento, procesamiento, acceso, inferencia y retención.
10. AI FinOps y arquitecturas sensibles al coste y la energía
La inteligencia artificial introduce una estructura de costes más dinámica que la analítica tradicional.
El consumo depende del modelo, tamaño del contexto, número de llamadas, herramientas utilizadas, caché, latencia, infraestructura y pasos que completa cada agente. Medir únicamente tokens o GPU no permite conocer la rentabilidad de un proceso.
- Te puede interesar: Microsoft Fabric cambiará el consumo de IA en octubre de 2026
AI FinOps ampliará las prácticas de cloud FinOps para relacionar consumo técnico con resultados. Las plataformas utilizarán routing dinámico entre modelos, caché semántica, cuantización, batching, límites de contexto y selección automática de infraestructura.
Una consulta sencilla podrá resolverse con un modelo pequeño; una decisión de alto riesgo puede requerir un sistema más avanzado y controles adicionales.
Implicación empresarial. La unidad financiera debe pasar del coste por token al coste por outcome: reclamación resuelta, incidencia evitada, documento procesado, pedido optimizado o proceso completado.
|
Métrica técnica |
Métrica operativa |
Métrica económica |
|
Tokens, GPU, almacenamiento y latencia |
Tareas completadas, reintentos y escalados |
Coste por proceso completado |
|
Hit rate de caché |
Tiempo de respuesta |
Productividad o conversión |
|
Utilización de capacidad |
Disponibilidad del servicio |
Margen incremental o ahorro |
|
Consumo energético |
Carga procesada |
Energía por outcome |
¿Quieres profundizar en estas tendencias?
El informe La Industria de los Datos y la IA en 2027-2028 analiza las 15 tendencias, sus implicaciones empresariales y los principales cambios que las organizaciones deberían empezar a considerar.
11. Identidad y autorización para agentes
Los agentes de IA se convertirán en identidades no humanas con acceso a datos, APIs y aplicaciones. Compartir credenciales de servicio o heredar todos los permisos de una persona será incompatible con un despliegue seguro a escala.
Cada agente necesitará una identidad propia, un propósito definido y permisos asociados a la tarea que desempeña. La autorización deberá distinguir entre consultar, recomendar y ejecutar. También será necesario gestionar delegación “en nombre de”, credenciales temporales, límites de gasto y revocación inmediata.
La trazabilidad debe vincular la identidad humana, el agente, el modelo, las herramientas utilizadas y la acción final. Esta cadena resulta esencial para investigación de incidentes, no repudio y cumplimiento.
Este punto cobra especial relevancia en el contexto del AI Act de la Unión Europea, que refuerza las exigencias relacionadas con la trazabilidad, la supervisión humana, la gestión del riesgo y la documentación de determinados sistemas de IA.
Implicación empresarial. Antes de ampliar la autonomía de un agente, la organización debe poder responder quién lo creó, para qué existe, a qué puede acceder, qué acciones puede ejecutar y cómo se desactiva.
¿Tu empresa está preparada para el AI Act? Consulta nuestra Guía Completa del AI Act para conocer las principales obligaciones, fechas y requisitos que deben tener en cuenta las organizaciones.
12. Decision Governance y controles en tiempo de ejecución
Un agente puede utilizar datos correctos y un modelo aprobado y, aun así, tomar una decisión inadecuada para el contexto.
Por eso surgirá una capa específica de decision governance: políticas que determinan qué decisiones puede tomar un sistema, con qué evidencia, dentro de qué límites y cuándo necesita aprobación humana.
Policy-as-code, contratos de datos y motores de reglas permitirán bloquear acciones fuera de política, registrar excepciones y adaptar límites según el riesgo.
La supervisión humana debe diseñarse de forma selectiva. Si todas las acciones requieren aprobación, desaparece el beneficio de la automatización; si ninguna la requiere, aumenta la exposición. La solución es graduar autonomía según impacto, reversibilidad, confianza y sensibilidad.
Implicación empresarial. La pregunta no será simplemente si un agente funciona, sino qué autoridad se le concede y cómo demuestra la organización que sus decisiones permanecen dentro de los límites establecidos.
|
Nivel |
Capacidad |
Ejemplo de control |
|
1. Asistencia |
Recupera y resume información |
Solo lectura y fuentes permitidas |
|
2. Recomendación |
Propone una decisión |
Evidencia y aprobación humana |
|
3. Acción limitada |
Ejecuta tareas reversibles |
Umbrales, límites y rollback |
|
4. Autonomía supervisada |
Gestiona workflows completos |
Monitorización continua y escalado |
13. Data Observability y AI Assurance
La observabilidad de datos evolucionará desde monitorizar pipelines y tablas hacia evaluar la cadena completa que conecta datos, contexto, modelos, agentes y resultados.
Freshness, completitud, schema y linaje seguirán siendo esenciales, pero deberán relacionarse con el impacto sobre una decisión o proceso.
AI assurance añade evaluación de groundedness, seguridad, robustez, sesgos, cumplimiento de políticas, coste y task success. Estas pruebas no pueden limitarse al momento previo al despliegue porque datos, prompts, herramientas y modelos cambian continuamente.
El principal riesgo será generar más telemetría de la que los equipos pueden interpretar. Los sistemas deberán priorizar alertas según impacto, agrupar causas relacionadas y recomendar respuestas.
Implicación empresarial. Una aplicación de IA no está realmente en producción si la organización no puede medir cuándo falla, por qué falla, a quién afecta y cuánto cuesta corregirla.
14. Privacidad computacional y datos sintéticos
La necesidad de utilizar información sensible para analítica e IA impulsará tecnologías capaces de reducir exposición sin bloquear la colaboración.
Differential privacy, federated learning, multiparty computation, homomorphic encryption, confidential computing y clean rooms ofrecen distintos mecanismos para trabajar con datos sin compartir directamente todos los registros brutos.
No existe una única tecnología aplicable a todos los casos. Algunas protegen resultados agregados; otras permiten entrenar modelos de manera distribuida; otras ejecutan cálculos sobre datos cifrados o dentro de entornos aislados.
La selección dependerá del nivel de riesgo, precisión, latencia y coste asumible.
Los datos sintéticos complementarán estas capacidades. Pueden facilitar pruebas, desarrollo, entrenamiento o intercambio cuando los datos reales son escasos o sensibles. Su utilidad depende de conservar las propiedades relevantes sin memorizar ni revelar registros originales.
Implicación empresarial. La privacidad debe diseñarse como una propiedad técnica medible. Cada caso de uso necesita una evaluación explícita de amenaza, utilidad, coste y evidencia de protección.
|
Enfoque |
Uso más habitual |
Trade-off principal |
|
Differential privacy |
Estadísticas y entrenamiento |
Precisión frente a protección |
|
Federated learning |
Entrenamiento distribuido |
Coordinación y heterogeneidad |
|
Clean rooms |
Colaboración entre organizaciones |
Casos limitados y dependencia de plataforma |
|
Confidential computing |
Procesamiento protegido |
Coste y compatibilidad |
|
Datos sintéticos |
Testing, desarrollo e intercambio |
Fidelidad y riesgo de memorización |
15. Data Products, Marketplaces y monetización
Un producto de datos es un activo diseñado para ser utilizado de forma repetida por consumidores concretos. Dispone de owner, documentación, contrato, calidad, permisos, SLO y mecanismos de soporte.
Los marketplaces internos facilitarán descubrimiento, solicitud de acceso y reutilización. Su éxito no dependerá del número de activos catalogados, sino de la calidad y adopción de aquellos que soportan procesos críticos.
Externamente, Data-as-a-Service evolucionará desde la venta de datasets estáticos hacia APIs, señales, features, scores y endpoints continuamente actualizados. Los modelos de negocio combinarán suscripción, consumo, compute, llamadas API, agentes o resultados.
La monetización no se limita a vender información. También incluye capturar valor interno mediante reducción de fraude, menor inventario, menos downtime, mejor pricing o mayor velocidad de lanzamiento. Cada producto debe conectarse con una cadena de métricas técnica, operativa y económica.
Implicación empresarial. Los datos deben gestionarse como una cartera. Cada producto necesita inversión, usuarios, coste, nivel de servicio, impacto y una decisión explícita sobre su continuidad.
Otras tecnologías emergentes que conviene vigilar en 2027-2028
Más allá de las 15 tendencias analizadas, el informe identifica varias tecnologías que conviene mantener en el radar de cara a 2027-2028, entre ellas Physical AI y world models, computación confidencial y nuevas aplicaciones de inteligencia artificial orientadas al descubrimiento científico.
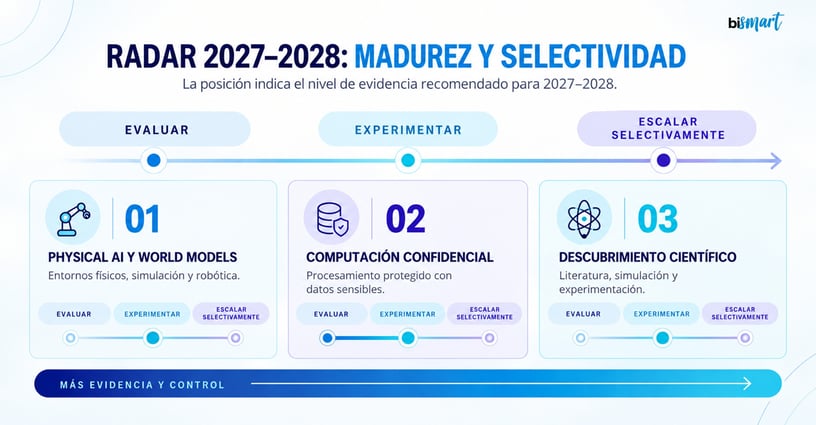
Su evolución dependerá de factores como la madurez tecnológica, la disponibilidad de casos de uso sólidos, los requisitos de seguridad y regulación, el coste de adopción y, sobre todo, la capacidad de demostrar un impacto empresarial tangible.
Por eso, anticipar el futuro de los datos y la IA no consiste en adoptar cada nueva tecnología que aparece, sino en identificar cuáles pueden generar una ventaja real para cada organización, en qué momento y bajo qué condiciones.
El verdadero reto de 2027-2028 será pasar de la IA disponible a la IA operativa
La carrera empresarial por la inteligencia artificial está cambiando. La ventaja difícilmente procederá únicamente de acceder a un modelo más potente. Los modelos serán cada vez más accesibles y sustituibles.
La diferencia aparecerá en la capacidad de una organización para conectarlos con datos fiables, conocimiento empresarial, procesos, controles y métricas de negocio.
Esto implica trabajar simultáneamente sobre arquitectura, gobierno, calidad, seguridad, observabilidad, costes y capacidades internas.
También explica por qué algunos de los principales riesgos de adopción identificados para los próximos años no son problemas del modelo de IA en sí, sino cuestiones como baja calidad de los datos, falta de ownership, costes sin control, seguridad de agentes, deuda de integración, soberanía o dependencia tecnológica.
La evolución de Data & AI entre 2027 y 2028 será, por tanto, menos una carrera por incorporar todas las novedades y más una cuestión de decidir cuáles tienen sentido para cada organización y construir las condiciones necesarias para utilizarlas de forma repetible, segura y rentable.
Descarga el informe 'La Industria de los Datos y la IA en 2027-2028'
¿Qué capacidades debería priorizar una empresa? ¿Qué tecnologías están suficientemente maduras? ¿Dónde se concentrará el valor? ¿Qué riesgos pueden bloquear la adopción?
En La Industria de los Datos y la IA en 2027-2028: Tendencias, retos y oportunidades, analizamos las cinco fuerzas que están transformando la industria, las 15 tendencias que conviene seguir y las implicaciones que pueden tener para las organizaciones.
El informe incluye además un radar de tecnologías emergentes, un mapa sectorial de creación de valor, una matriz de riesgos de adopción y un roadmap ejecutivo 2026-2028 para pasar de las tendencias a las prioridades.